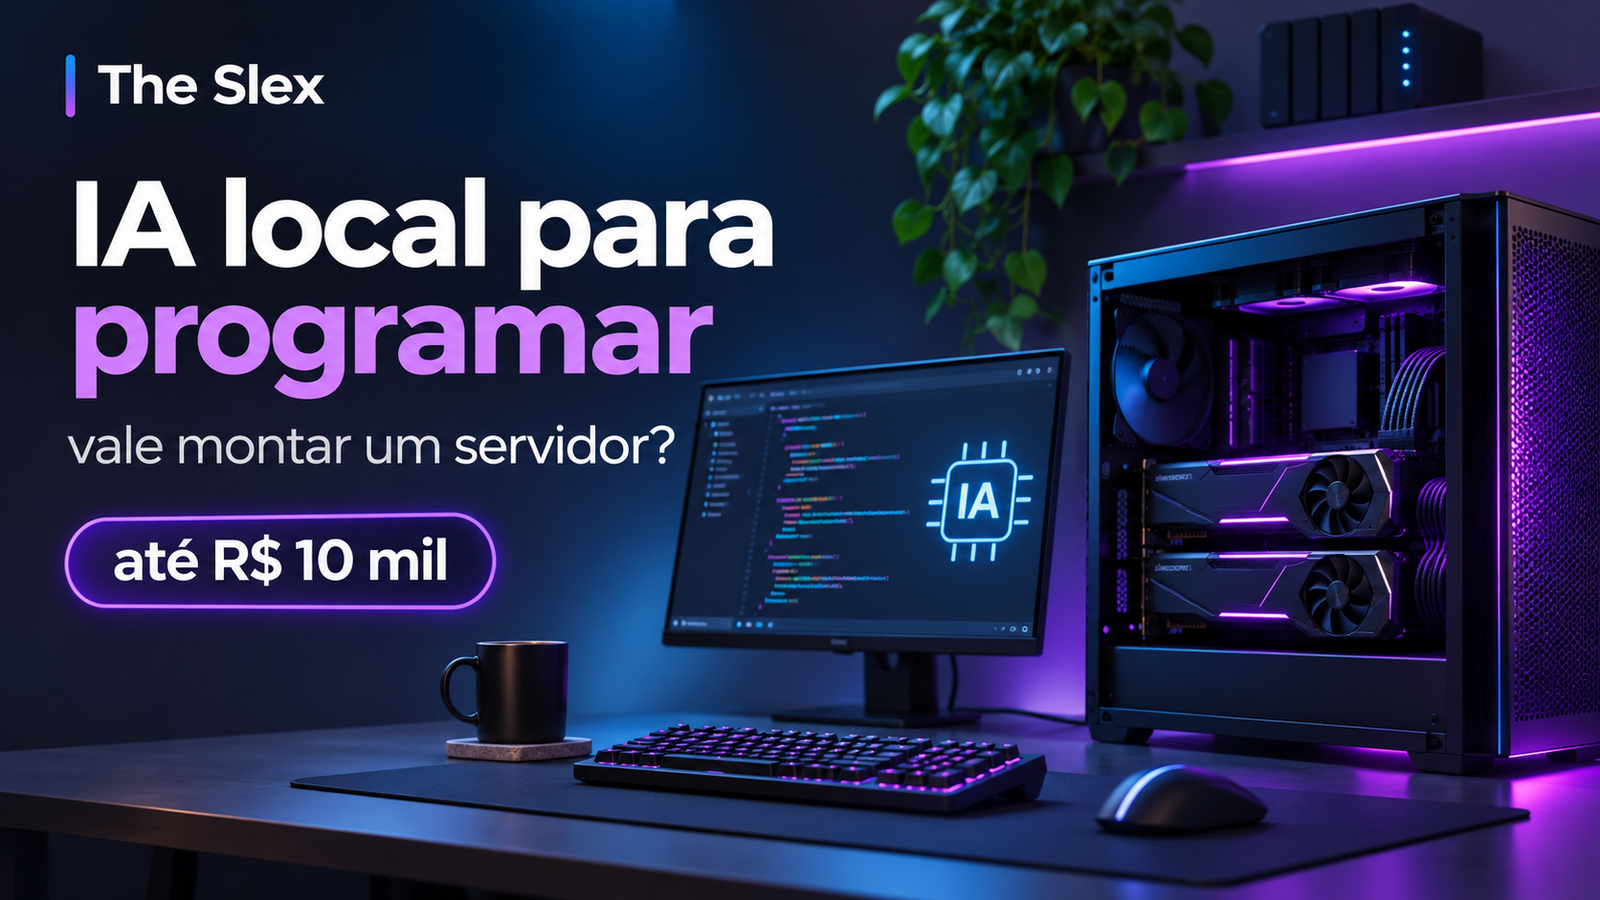
Depois de testar alguns modelos menores de inteligência artificial, comecei a pensar em uma possibilidade que pode interessar a muitos desenvolvedores: será que conseguimos montar uma máquina dedicada à IA sem investir uma fortuna em hardware de última geração?
A minha ideia é montar um servidor dedicado à inteligência artificial local, aproveitando peças de servidores antigos e placas de vídeo com bastante memória VRAM. Não seria um computador principal para navegar, jogar ou trabalhar diretamente: seria uma segunda máquina, preparada para executar modelos de IA pela rede, crescendo conforme o orçamento permitir.
Por que quero executar uma IA local?
Hoje usamos ferramentas como ChatGPT, Claude e Codex para desenvolver sistemas, corrigir problemas e analisar projetos. Mas, quando o trabalho envolve código de verdade, não basta um modelo que responda perguntas simples. É preciso compreender arquivos, dependências, erros e alterações feitas ao longo de várias etapas.
Também me interessa ter mais controle sobre o ambiente, os dados do projeto e os custos. Uma IA local não resolve automaticamente todos os riscos de segurança, mas pode reduzir a necessidade de enviar código para serviços externos, desde que o servidor seja configurado e protegido corretamente.
Qual modelo usar para programação?
Modelos comerciais avançados, como GPT e Claude, servem como referência de capacidade, mas não podemos simplesmente baixar os pesos dos modelos fechados e instalá-los em casa. Também não é tão simples extrair apenas uma “parte de código” dos pesos para obter uma versão menor com a mesma qualidade.
Por isso, pretendo avaliar alternativas com pesos disponíveis para execução local, especialmente modelos da família Qwen voltados à programação e outras opções abertas compatíveis com a memória das GPUs. O objetivo não é declarar um vencedor antes de testar, mas descobrir quais modelos conseguem fazer correções, analisar projetos e acompanhar tarefas reais.
Servidor Xeon: economizar na base e investir em GPUs
Minha proposta inicial é pesquisar kits Xeon e placas-mãe de servidor ou workstation, inclusive componentes usados. Alguns processadores oferecem muitos núcleos por preços interessantes. Mas é importante lembrar: para inferência de modelos de linguagem, a capacidade e o desempenho da GPU frequentemente pesam mais do que a quantidade de núcleos da CPU.
Uma possibilidade é começar com uma placa de 12 GB de VRAM e depois adicionar outra. Duas placas de 12 GB somam 24 GB de memória gráfica instalada, mas não formam automaticamente uma única memória de 24 GB: o modelo e o software precisam suportar a distribuição da carga entre GPUs. No futuro, gostaria de estudar configurações com 40 GB ou mais de VRAM.
Outro ponto que não podemos ignorar é a compatibilidade do conjunto: slots PCI Express, espaço no gabinete, ventilação, potência da fonte, conectores de energia, memória RAM e consumo elétrico. Algumas GPUs de servidor, como a Tesla P40, usam refrigeração passiva e exigem fluxo de ar apropriado, além de apresentarem limitações com ferramentas modernas.
Peças para pesquisar no Mercado Livre
Para quem também quer estudar uma montagem de baixo custo, separei quatro links. São referências para comparar produtos, não uma configuração de compra já validada. Confira o estado, a garantia, as especificações e a compatibilidade antes de comprar.
- Kit Xeon X99: ver kit no Mercado Livre.
- RTX 3060 de 12 GB: ver placa no Mercado Livre.
- NVIDIA Tesla P40 de 24 GB: ver aceleradora no Mercado Livre.
- Colorful iGame RTX 3090 de 24 GB: ver placa no Mercado Livre.
Transparência: este artigo contém links de afiliados. Uma compra realizada por esses links pode gerar comissão, sem custo adicional para você. Preços e disponibilidade podem mudar.
Será que dá para montar tudo com R$ 10 mil?
Esse é o orçamento que quero investigar, não uma promessa de preço final. Em servidores voltados para IA, as GPUs podem representar a maior parte do investimento. Um kit Xeon econômico ajuda, mas ainda precisamos incluir fonte, RAM, SSD, gabinete, refrigeração e possíveis adaptações. Uma máquina antiga também pode consumir bastante energia ao longo do tempo.
Em vez de comprar as peças imediatamente, pretendo estudar os anúncios brasileiros, escolher combinações viáveis e verificar o custo total. Dependendo do modelo de IA escolhido, pode fazer mais sentido ter uma única GPU com 24 GB do que várias menores.
Antes de comprar: testar os modelos no Google Colab
O próximo passo será carregar um modelo maior de programação no Google Colab e colocá-lo para trabalhar em tarefas reais: entender arquivos, corrigir bugs, criar funcionalidades e manter o contexto de um projeto. O Colab Pro pode oferecer acesso a GPUs e mais recursos, mas não significa uso ilimitado nem disponibilidade garantida de um tipo específico de hardware.
Também quero investigar a integração com ferramentas de desenvolvimento como o Codex CLI, que pode trabalhar com provedores de modelos locais. Conectar um ambiente remoto do Colab exigirá configuração adicional; não é o mesmo que simplesmente instalar um modelo em uma máquina doméstica.
Uma máquina dedicada, construída por etapas
Minha proposta é começar com o que for realmente útil e ampliar o servidor aos poucos, conforme os testes apontarem necessidade. Assim, continuo programando no computador principal enquanto uma segunda máquina executa os modelos pela rede.
Se a IA conseguir analisar um projeto, corrigir problemas e ajudar nas tarefas diárias com desempenho aceitável, já será um avanço interessante. Não precisamos necessariamente superar os modelos comerciais mais caros: precisamos encontrar o melhor custo-benefício para nosso trabalho.
Vou compartilhar os resultados dos testes, as dificuldades e as escolhas de hardware. Antes de gastar R$ 10 mil, quero descobrir qual modelo realmente vale a pena executar e qual máquina consegue sustentá-lo.
Autor: Almerindo Junior
Autor

almerindoocara@gmail.com
Posts relacionados
Como criei minha própria cifra em PHP inspirado por O Jogo da Imitação
- 0
- 1.476 word
Como um filme sobre Alan Turing despertou minha curiosidade e me levou a desenvolver uma cifra de substituição em PHP. Conheça a...
Leia tudo
LFM3-Omni-2B: testei a IA local de 2 bilhões de parâmetros na CPU
- 0
- 1.746 word
Testei a LFM3-Omni-2B na CPU usando Docker. Confira meus experimentos com texto, leitura de código PHP em imagem, áudio e velocidade em...
Do Dogecoin ao ataque de US$ 6,3 bilhões à Binance em 2026: PHP, IA e segurança cripto
- 0
- 2.730 words
Minha experiência com Dogecoin e PHP se conecta ao ataque de US$ 6,3 bilhões à Binance em 2026, às suspeitas sobre hackers...

Como criar um agente de IA para WhatsApp com n8n: automação, orquestradores e segurança
- 0
- 2.454 words
Entenda como criar um agente de IA para WhatsApp com n8n, utilizando orquestradores, agentes especialistas, automações e segurança.

IA local: velocidade, contexto e parâmetros dos LLMs
- 1
- 1.794 word
Descubra como tokens por segundo, janela de contexto e parâmetros afetam o desempenho da IA local. Experiências com Qwen, DeepSeek, Mac e...
Leia tudo
IA e o desenvolvimento tecnológico e intelectual: como a inteligência artificial está ampliando a capacidade humana
- 1
- 1.247 word
Da ficção científica aos modelos locais, a inteligência artificial está ampliando nossa capacidade de analisar dados, criar soluções e desenvolver novas ideias....
Leia tudo